


הסבר על קריאות וכתיבות בקנה מידה גדול
במאמר הזה מוסבר איך לתכנן את הארכיטקטורה של האפליקציות כדי להשיג ביצועים גבוהים ומהימנות. המסמך הזה כולל נושאים מתקדמים ב-Firestore. אם אתם רק מתחילים להשתמש ב-Firestore, כדאי לעיין במדריך למתחילים.
Firestore הוא מסד נתונים גמיש וניתן להרחבה לפיתוח אפליקציות לנייד, לאינטרנט ולשרתים מבית Firebase ו- Google Cloud. קל מאוד להתחיל לעבוד עם Firestore ולכתוב אפליקציות עשירות וחזקות.
כדי לוודא שהאפליקציות ימשיכו לפעול בצורה טובה ככל שגודל מסד הנתונים והתנועה יגדלו, כדאי להבין את המנגנונים של פעולות קריאה וכתיבה ב-Firestore backend. חשוב גם להבין את האינטראקציה של פעולות הקריאה והכתיבה עם שכבת האחסון ואת האילוצים הבסיסיים שעשויים להשפיע על הביצועים.
לפני שתתכננו את האפליקציה, כדאי לעיין בשיטות המומלצות שמפורטות בקטעים הבאים.
הסבר על הרכיבים ברמה הגבוהה
התרשים הבא מציג את הרכיבים ברמה הגבוהה שמעורבים בבקשת Firestore API.

ערכת ה-SDK וספריות הלקוח של Firestore
Firestore תומך בערכות SDK ובספריות לקוח לפלטפורמות שונות. אפליקציה יכולה לבצע קריאות ישירות ל-HTTP ול-RPC ל-Firestore API, אבל ספריות הלקוח מספקות שכבת הפשטה כדי לפשט את השימוש ב-API ולהטמיע שיטות מומלצות. יכול להיות שהם יספקו גם תכונות נוספות כמו גישה אופליין, מטמונים וכו'.
ממשק קצה של Google (GFE)
זהו שירות תשתיתי שמשותף לכל שירותי הענן של Google. GFE מקבל בקשות נכנסות ומעביר אותן לשירות Google הרלוונטי (שירות Firestore בהקשר הזה). הוא גם מספק פונקציות חשובות אחרות, כולל הגנה מפני התקפות מניעת שירות (DoS).
שירות Firestore
שירות Firestore מבצע בדיקות בבקשת ה-API, כולל אימות, הרשאה, בדיקות מכסה וכללי אבטחה, וגם מנהל טרנזקציות. שירות Firestore כולל לקוח אחסון שמקיים אינטראקציה עם שכבת האחסון לצורך קריאה וכתיבה של נתונים.
שכבת האחסון של Firestore
שכבת האחסון של Firestore אחראית לאחסון הנתונים והמטא-נתונים, ולתכונות מסד הנתונים המשויכות שמסופקות על ידי Firestore. בקטעים הבאים מתואר איך הנתונים מאורגנים בשכבת האחסון של Firestore ואיך המערכת מתרחבת. הבנה של אופן ארגון הנתונים יכולה לעזור לכם לתכנן מודל נתונים שניתן להרחבה, ולהבין טוב יותר את השיטות המומלצות ב-Firestore.
טווחים ופיצולים של מקשים
Firestore הוא מסד נתונים של NoSQL, שמבוסס על מסמכים. הנתונים מאוחסנים במסמכים, שמסודרים בהיררכיות של אוספים. היררכיית האוסף ומזהה המסמך מתורגמים למפתח יחיד לכל מסמך. המסמכים מאוחסנים באופן לוגי ומסודרים לפי סדר מילוני לפי המפתח היחיד הזה. אנחנו משתמשים במונח 'טווח מפתחות' כדי להתייחס לטווח רציף של מפתחות בסדר לקסיקוגרפי.
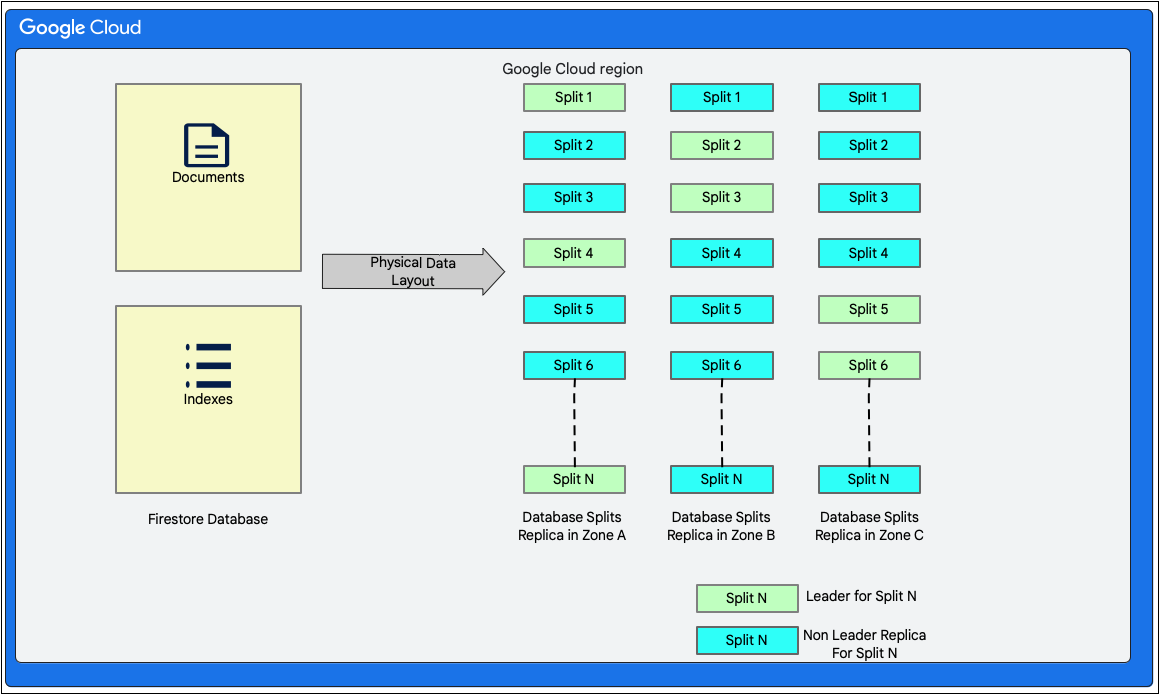
בדרך כלל, מסד נתונים ב-Firestore גדול מדי מכדי להיכנס למכונה פיזית אחת. יש גם תרחישים שבהם עומס העבודה על הנתונים כבד מדי בשביל שמחשב אחד יוכל לטפל בו. כדי לטפל בעומסי עבודה גדולים, מערכת Firestore מחלקת את הנתונים לחלקים נפרדים שאפשר לאחסן ולהציג ממכונות מרובות או משרתי אחסון. המחיצות האלה נוצרות בטבלאות של מסד הנתונים בבלוקים של טווחי מפתחות שנקראים פיצולים.
שכפול סינכרוני
חשוב לציין שהמסד נתונים תמיד משוכפל באופן אוטומטי וסינכרוני. לפילוגים של הנתונים יש רפליקות באזורים שונים, כדי שהם יישארו זמינים גם אם לא תהיה גישה לאזור מסוים. השכפול העקבי של העותקים השונים של הפיצול מנוהל על ידי אלגוריתם Paxos להשגת הסכמה. עותק אחד של כל פיצול נבחר לפעול כמנהיג Paxos, שאחראי לטיפול בפעולות כתיבה לפיצול הזה. השכפול הסינכרוני מאפשר לכם לקרוא תמיד את הגרסה העדכנית ביותר של הנתונים מ-Firestore.
התוצאה הכוללת היא מערכת ניתנת להרחבה עם זמינות גבוהה, שמספקת זמני אחזור נמוכים לקריאה ולכתיבה, ללא קשר לעומסי עבודה כבדים ובקנה מידה גדול מאוד.
פריסת נתונים
Firestore הוא מסד נתונים של מסמכים ללא סכימה. עם זאת, באופן פנימי, הנתונים מסודרים בעיקר בשתי טבלאות בסגנון מסד נתונים יחסי בשכבת האחסון, באופן הבא:
- טבלת Documents: המסמכים מאוחסנים בטבלה הזו.
- טבלת Indexes: בטבלה הזו מאוחסנים רשומות אינדקס שמאפשרות לקבל תוצאות בצורה יעילה וממוינות לפי ערך האינדקס.
בתרשים הבא אפשר לראות איך הטבלאות במסד נתונים של Firestore יכולות להיראות אחרי הפיצול. הפיצולים משוכפלים בשלושה אזורים שונים, ולכל פיצול מוקצה מוביל Paxos.
אזור יחיד לעומת מספר אזורים
כשיוצרים מסד נתונים, צריך לבחור אזור או מספר אזורים.
מיקום אזורי יחיד הוא מיקום גיאוגרפי ספציפי, כמו us-west1. הפיצולים של נתוני מסד נתונים של Firestore כוללים רפליקות באזורים שונים בתוך האזור שנבחר, כפי שהוסבר קודם.
מיקום רב-אזורי כולל קבוצה מוגדרת של אזורים שבהם מאוחסנות רפליקות של מסד הנתונים. בפריסה של Firestore במספר אזורים, שניים מהאזורים כוללים עותקים מלאים של כל הנתונים במסד הנתונים. באזור שלישי יש עותק משני של עֵד שלא מכיל את כל הנתונים, אבל משתתף בשכפול. העתקת הנתונים בין כמה אזורים מאפשרת לכתוב ולקרוא נתונים גם במקרה של אובדן אזור שלם.
מידע נוסף על המיקומים של אזור מסוים זמין במאמר מיקומי Firestore.

הסבר על מחזור החיים של פעולת כתיבה ב-Firestore
לקוח Firestore יכול לכתוב נתונים על ידי יצירה, עדכון או מחיקה של מסמך יחיד. כתיבה למסמך יחיד מחייבת עדכון אטומי של המסמך ושל רשומות האינדקס שמשויכות אליו בשכבת האחסון. ב-Firestore יש גם תמיכה בפעולות אטומיות שכוללות כמה קריאות או כתיבות למסמך אחד או יותר.
לכל סוגי הכתיבה, Firestore מספק את מאפייני ה-ACID (אטומיות, עקביות, בידוד ועמידות) של מסדי נתונים רלציוניים. ב-Firestore יש גם serializability, כלומר כל העסקאות מוצגות כאילו הן בוצעו בסדר מסוים.
שלבים כלליים בעסקת כתיבה
כשלקוח Firestore מנפיק פעולת כתיבה או מבצע עסקה, באמצעות אחת מהשיטות שצוינו קודם, הפעולה הזו מבוצעת באופן פנימי כעסקה של קריאה וכתיבה במסד נתונים בשכבת האחסון. הטרנזקציה מאפשרת ל-Firestore לספק את מאפייני ה-ACID שצוינו קודם.
בשלב הראשון של העסקה, Firestore קורא את המסמך הקיים וקובע את השינויים שיש לבצע בנתונים בטבלת המסמכים.
הפעולה הזו כוללת גם ביצוע עדכונים נדרשים בטבלת האינדקסים, באופן הבא:
- השדות שמוסיפים למסמכים צריכים להיות תואמים להוספות בטבלת האינדקסים.
- כשמסירים שדות מהמסמכים, צריך להסיר אותם גם מטבלת האינדקסים.
- בשדות שמשתנים במסמכים, צריך גם מחיקות (של ערכים ישנים) וגם הוספות (של ערכים חדשים) בטבלת האינדקסים.
כדי לחשב את המוטציות שצוינו קודם, Firestore קורא את הגדרת יצירת האינדקס של מסד הנתונים. הגדרת האינדקס כוללת מידע על האינדקסים של מסד נתונים. ב-Firestore יש שני סוגים של אינדקסים: אינדקסים של שדה יחיד ואינדקסים מורכבים. למידע מפורט על האינדקסים שנוצרו ב-Firestore, אפשר לעיין במאמר סוגי אינדקסים ב-Firestore.
אחרי שהמערכת מחשבת את השינויים, היא אוספת אותם בתוך טרנזקציה ואז מבצעת את הפעולה.
הסבר על עסקת כתיבה בשכבת האחסון
כמו שהסברנו קודם, פעולת כתיבה ב-Firestore כוללת טרנזקציית קריאה-כתיבה בשכבת האחסון. בהתאם לפריסת הנתונים, פעולת כתיבה עשויה לכלול פיצול אחד או יותר, כפי שמוצג בפריסת הנתונים.
בתרשים הבא, מסד הנתונים של Firestore מחולק לשמונה חלקים (מסומנים ב-1 עד 8) שמתארחים בשלושה שרתי אחסון שונים באותו אזור, וכל חלק משוכפל בשלושה אזורים שונים(או יותר). לכל פיצול יש מנהיג Paxos, שיכול להיות באזור אחר עבור פיצולים שונים.

נניח שיש לכם מסד נתונים ב-Firestore עם אוסף Restaurants באופן הבא:

לקוח Firestore מבקש לבצע את השינוי הבא במסמך באוסף Restaurant על ידי עדכון הערך של השדה priceCategory.

השלבים הבאים מתארים באופן כללי מה קורה כחלק מהכתיבה:
- יוצרים טרנזקציה עם הרשאות קריאה וכתיבה.
- קריאת המסמך
restaurant1באוסףRestaurantsמהטבלה Documents משכבת האחסון. - קוראים את האינדקסים של המסמך מהטבלה Indexes.
- חישוב השינויים שצריך לבצע בנתונים. במקרה הזה, יש חמש מוטציות:
- M1: מעדכנים את השורה של
restaurant1בטבלה Documents כך שתשקף את השינוי בערך של השדהpriceCategory. - M2 ו-M3: מוחקים את השורות של הערך הישן של
priceCategoryבטבלה Indexes (אינדקסים) עבור אינדקסים בסדר יורד ואינדקסים בסדר עולה. - M4 ו-M5: מוסיפים את השורות לערך החדש של
priceCategoryבטבלה Indexes לאינדקסים בסדר יורד ועולה.
- M1: מעדכנים את השורה של
- מאשרים את המוטציות האלה.
לקוח האחסון בשירות Firestore מחפש את הפיצולים שכוללים את המפתחות של השורות שרוצים לשנות. נניח שפילוג 3 מציג את M1, ופילוג 6 מציג את M2-M5. מדובר בעסקה מבוזרת, שבה כל הפיצולים האלה הם משתתפים. הפיצולים של המשתתפים עשויים לכלול גם פיצולים אחרים שמהם נתונים נקראו קודם כחלק מעסקת הקריאה והכתיבה.
בשלבים הבאים מוסבר מה קורה כחלק מההתחייבות:
- לקוח האחסון שולח אישור. השמירה מכילה את המוטציות M1-M5.
- המשתתפים בעסקה הזו הם 3 ו-6. אחד מהמשתתפים נבחר להיות המתאם, כמו Split 3. תפקיד המתאם הוא לוודא שהעסקה תתבצע או תבוטל באופן אטומי אצל כל המשתתפים.
- הרפליקות הראשיות של הפיצולים האלה אחראיות לעבודה שמבצעים המשתתפים והמתאמים.
- כל משתתף וכל מתאם מריצים אלגוריתם Paxos עם העותקים המתאימים שלהם.
- המוביל מריץ אלגוריתם Paxos עם העותקים. הקונצנזוס מושג אם רוב העותקים משיבים למנהיג בתגובה
ok to commit. - כל משתתף מודיע לרכז כשהוא מוכן (השלב הראשון מתוך שני שלבים של אישור פעולה). אם אחד מהמשתתפים לא יכול לאשר את העסקה, העסקה כולה
aborts.
- המוביל מריץ אלגוריתם Paxos עם העותקים. הקונצנזוס מושג אם רוב העותקים משיבים למנהיג בתגובה
- אחרי שהמתאם יודע שכל המשתתפים, כולל הוא עצמו, מוכנים, הוא מעביר את תוצאת העסקה
acceptלכל המשתתפים (השלב השני של אישור דו-שלבי). בשלב הזה, כל משתתף מתעד את החלטת האישור באחסון יציב והעסקה מאושרת. - המתאם משיב ללקוח האחסון ב-Firestore שהטרנזקציה בוצעה. במקביל, הרכיב המתאם וכל המשתתפים מחילים את השינויים על הנתונים.

כשמסד הנתונים של Firestore קטן, יכול להיות שפיצול יחיד יהיה הבעלים של כל המפתחות במוטציות M1-M5. במקרה כזה, יש רק משתתף אחד בעסקה, ולא נדרשת התחייבות דו-שלבית שצוינה קודם לכן, ולכן פעולות הכתיבה מהירות יותר.
כתיבה במספר אזורים
בפריסה מרובת אזורים, פיזור העותקים המשוכפלים בין האזורים מגדיל את הזמינות, אבל יש לכך השפעה על הביצועים. התקשורת בין העותקים באזורים שונים אורכת יותר זמן. לכן, זמן האחזור הבסיסי לפעולות ב-Firestore גבוה יותר בהשוואה לפריסות באזור יחיד.
אנחנו מגדירים את העותקים המשוכפלים כך שההובלה של הפיצולים תמיד תישאר באזור הראשי. האזור הראשי הוא האזור שממנו מגיעה תנועה לשרת Firestore. ההחלטה הזו של ההנהלה מקטינה את ההשהיה בחיבור (RTT) בתקשורת בין לקוח האחסון ב-Firestore לבין העותק הראשי (או הרכיב המתאם לעסקאות מרובות פיצולים).
כל פעולת כתיבה ב-Firestore כוללת גם אינטראקציה מסוימת עם מנוע בזמן אמת ב-Firestore. מידע נוסף על שאילתות בזמן אמת זמין במאמר הסבר על שאילתות בזמן אמת בהיקף גדול.
הסבר על מחזור החיים של פעולת קריאה ב-Firestore
בקטע הזה נסביר על קריאות עצמאיות ב-Firestore שלא מתבצעות בזמן אמת. באופן פנימי, שרת Firestore מטפל ברוב השאילתות האלה בשני שלבים עיקריים:
- סריקה של טווח יחיד בטבלת האינדקסים
- חיפושים נקודתיים בטבלה מסמכים על סמך תוצאות הסריקה הקודמת
קריאות הנתונים משכבת האחסון מתבצעות באופן פנימי באמצעות טרנזקציה במסד נתונים, כדי להבטיח קריאות עקביות. עם זאת, בניגוד לעסקאות שמשמשות לכתיבה, העסקאות האלה לא נועלות את הנתונים. במקום זאת, הן פועלות על ידי בחירת חותמת זמן, ואז ביצוע כל פעולות הקריאה בחותמת הזמן הזו. מכיוון שהם לא מקבלים נעילות, הם לא חוסמים עסקאות בו-זמניות של קריאה וכתיבה. כדי לבצע את העסקה הזו, לקוח האחסון ב-Firestore מציין חותמת זמן של גבול, שמציינת לשכבת האחסון איך לבחור חותמת זמן של קריאה. סוג חותמת הזמן שמוגדרת על ידי לקוח האחסון ב-Firestore נקבע לפי אפשרויות הקריאה של בקשת הקריאה.
הסבר על עסקת קריאה בשכבת האחסון
בקטע הזה מתוארים סוגי הקריאות ואופן העיבוד שלהן בשכבת האחסון ב-Firestore.
קריאות חזקות
כברירת מחדל, פעולות קריאה ב-Firestore הן עקביות חזקות. עקביות חזקה כזו אומרת שקריאה ב-Firestore מחזירה את הגרסה העדכנית ביותר של הנתונים, שמשקפת את כל הכתיבות שבוצעו עד תחילת הקריאה.
קריאה של מסך מפוצל יחיד
לקוח האחסון ב-Firestore מחפש את הפיצולים שכוללים את המפתחות של השורות שצריך לקרוא. נניח שהיא צריכה לקרוא מ-Split 3 מהקטע הקודם. הלקוח שולח את בקשת הקריאה לרפליקה הקרובה ביותר כדי לצמצם את זמן האחזור של הלוך ושוב.
בשלב הזה, יכולים לקרות המקרים הבאים, בהתאם לשכפול שנבחר:
- בקשת קריאה מועברת לרפליקה ראשית (אזור א').
- המוביל תמיד מעודכן, ולכן הקריאה יכולה להתבצע ישירות.
- בקשת קריאה מועברת לרפליקה שאינה רפליקת הלידר (לדוגמה, אזור ב')
- יכול להיות ש-Split 3 ידע לפי המצב הפנימי שלו שיש לו מספיק מידע כדי להציג את הקריאה, והוא יעשה זאת.
- הפיצול השלישי לא בטוח אם הוא ראה את הנתונים האחרונים. הוא שולח הודעה למוביל כדי לבקש את חותמת הזמן של העסקה האחרונה שהוא צריך להחיל כדי להציג את הקריאה. אחרי שהעסקה הזו תיושם, הקריאה תוכל להימשך.
לאחר מכן, Firestore מחזיר את התגובה ללקוח שלו.
קריאה עם פיצול מסך
במצב שבו צריך לקרוא נתונים מכמה פיצולים, אותו מנגנון פועל בכל הפיצולים. אחרי שהנתונים מוחזרים מכל הפיצולים, לקוח האחסון ב-Firestore משלב את התוצאות. לאחר מכן, Firestore משיב ללקוח עם הנתונים האלה.
קריאות בעבר
קריאות חזקות הן מצב ברירת המחדל ב-Firestore. עם זאת, יש לכך מחיר: השהיה גבוהה יותר בגלל התקשורת שנדרשת עם הצומת הראשי. לרוב, האפליקציה שלכם ב-Firestore לא צריכה לקרוא את הגרסה האחרונה של הנתונים, והפונקציונליות פועלת היטב עם נתונים שיכול להיות שהם לא עדכניים בכמה שניות.
במקרה כזה, הלקוח יכול לבחור לקבל קריאות לא עדכניות באמצעות read_time אפשרויות הקריאה. במקרה הזה, פעולות הקריאה מתבצעות כשהנתונים היו ב-read_time, וככל הנראה העותק המשוכפל הכי קרוב כבר אימת שיש בו נתונים ב-read_time שצוין.
כדי ליהנות מביצועים טובים יותר באופן משמעותי, מומלץ להגדיר ערך של 15 שניות. גם בקריאות לא עדכניות, השורות שמתקבלות עקביות זו עם זו.
הימנעות מנקודות חמות
הפיצולים ב-Firestore מפורקים אוטומטית לחלקים קטנים יותר כדי לחלק את עבודת הצגת התנועה ליותר שרתי אחסון כשצריך או כשמרחב המפתחות מתרחב. פיצולים שנוצרו כדי לטפל בעודף תנועה נשמרים למשך כ-24 שעות, גם אם התנועה נעלמת. לכן, אם יש עליות חוזרות בתנועה, הפיצולים נשמרים ופיצולים נוספים מוצגים כשנדרש. המנגנונים האלה עוזרים למסדי נתונים של Firestore לבצע שינוי גודל אוטומטי כשיש עלייה בעומס התנועה או בגודל מסד הנתונים. עם זאת, יש כמה מגבלות שחשוב להכיר, כפי שמפורט בהמשך.
פיצול האחסון והעומס לוקח זמן, והגדלת נפח התנועה מהר מדי עלולה לגרום לזמן אחזור גבוה או לשגיאות של חריגה מהזמן הקצוב לתפוגה, שנקראות בדרך כלל נקודות חמות, בזמן שהשירות מבצע התאמות. השיטה המומלצת היא לפזר את הפעולות על פני טווח המפתחות, תוך הגדלת התנועה באוסף במסד נתונים עם 500 פעולות בשנייה. אחרי העלייה ההדרגתית הזו, מגדילים את התנועה ב-50% כל חמש דקות. התהליך הזה נקרא כלל 500/50/5, והוא מאפשר למסד הנתונים להתרחב בצורה אופטימלית כדי לעמוד בעומס העבודה.
למרות שהפיצולים נוצרים אוטומטית עם העלייה בעומס, Firestore יכול לפצל טווח מפתחות רק עד שהוא משרת מסמך יחיד באמצעות קבוצה ייעודית של שרתי אחסון משוכפלים. כתוצאה מכך, נפחים גבוהים ומתמשכים של פעולות בו-זמניות במסמך יחיד עלולים להוביל לנקודה חמה במסמך הזה. אם נתקלתם בחביון גבוה באופן עקבי במסמך יחיד, כדאי לשקול לשנות את מודל הנתונים כדי לפצל את הנתונים או לשכפל אותם בכמה מסמכים.
שגיאות של התנגשות מתרחשות כשכמה פעולות מנסות לקרוא ו/או לכתוב את אותו מסמך בו-זמנית.
מקרה מיוחד נוסף של hotspotting מתרחש כשמשתמשים במפתח עם ערכים עולים או יורדים ברצף כמזהה המסמך ב-Firestore, ויש מספר גבוה במיוחד של פעולות בשנייה. יצירת פיצולים נוספים לא תעזור במקרה הזה, כי העלייה בתנועה פשוט תעבור לפיצול החדש שנוצר. מכיוון ש-Firestore יוצר באופן אוטומטי אינדקס לכל השדות במסמך כברירת מחדל, יכול להיות שגם במרחב האינדקס ייווצרו נקודות חמות כאלה לשדה במסמך שמכיל ערך שעולה או יורד ברצף, כמו חותמת זמן.
שימו לב: אם תפעלו לפי השיטות המומלצות שצוינו למעלה, תוכלו להרחיב את Firestore כדי לתמוך בעומסי עבודה גדולים ככל שיידרש, בלי שתצטרכו לשנות את ההגדרות.
פתרון בעיות
Firestore מספק את Key Visualizer ככלי אבחון שנועד לנתח דפוסי שימוש ולפתור בעיות שקשורות לנקודות חמות.