


Mit der Datenherkunft können Sie nachvollziehen, wie Daten durch Ihre Systeme fließen, indem Sie die Beziehungen zwischen Daten-Assets und den Prozessen, die sie transformieren, verfolgen. Sie können diese Informationen zur Herkunft in der Google Cloud -Konsole als Diagramme und Listen ansehen.
In diesem Dokument wird die Granularität der Datenherkunft auf Tabellen- und Spaltenebene beschrieben. Außerdem finden Sie hier eine Anleitung dazu, wie Sie die Datenherkunft in der Google Cloud Console mithilfe von Diagramm- und Listenansichten untersuchen.
Weitere Informationen zum zugrunde liegenden Datenmodell finden Sie im Informationsmodell für den Datenursprung.
Unterschiede zwischen Zeilen auf Tabellen- und Spaltenebene
Mit Data Lineage können Sie den Ursprung und den Transformationspfad Ihrer Daten sowohl auf Tabellen- als auch auf Spaltenebene nachvollziehen.
Wann sollte die Zeilen auf Tabellenebene verwendet werden?
Der Lineage auf Tabellenebene bietet einen allgemeinen Überblick über Ihre Datenpipelines, indem die Beziehungen zwischen ganzen Tabellen dargestellt werden. Verwenden Sie den Datenursprung auf Tabellenebene für Makroaufgaben wie die folgenden:
Datenerkennung: Ein Analyst, der ein neues Dashboard erstellt, kann die Herkunft auf Tabellenebene verwenden, um eine Zusammenfassungstabelle auf ihre Quellen zurückzuführen und zu bestätigen, dass die Daten aus einer autoritativen Datenbank stammen.
Planung der Migration. Ein Datenbankadministrator, der die Migration einer wichtigen Datenbank plant, kann die Herkunft auf Tabellenebene verwenden, um alle nachgelagerten Berichte und Dashboards zu ermitteln, die von der Datenbank abhängen.
Analyse und Governance: Ein Data Governor kann die Datenherkunft auf Tabellen- und Spaltenebene verwenden, um zu prüfen, wie Daten aus einer Tabelle mit personenidentifizierbaren Informationen durch eine Pipeline fließen.
Wann sollte die Herkunft auf Spaltenebene verwendet werden?
Die Lineage auf Spaltenebene bietet eine detailliertere Ansicht, da der Datenfluss zwischen einzelnen Spalten nachverfolgt wird. In dieser Ansicht stellen die Links in einem Lineage-Ereignis die Beziehung zwischen einer Quellspalte und einer Zielspalte dar. Jeder dieser Links auf Spaltenebene hat einen Abhängigkeitstyp, der die Transformation beschreibt:
Exact copy: Werte werden zwischen Spalten kopiert.Other: andere Arten von Abhängigkeiten zwischen Spalten.
Sie können die Herkunft auf Spaltenebene für Aufgaben wie die folgenden verwenden:
Ursachenanalyse: Wenn ein Data Analyst einen falschen Wert in einer Spalte findet, kann er die Herkunft auf Spaltenebene verwenden, um den Wert bis zu den Quellspalten zurückzuverfolgen und die Ursache zu ermitteln.
Wirkungsanalyse: Bevor ein Data Engineer eine Spalte einstellt, kann er die Herkunft auf Spaltenebene verwenden, um alle nachgelagerten Spalten zu finden, die davon abhängen.
Datenquellenbestätigung für Messwerte: Mit der Herkunft auf Spaltenebene kann ein Datenanalyst ermitteln, welche Quellspalten zum Berechnen eines Messwerts verwendet werden, ohne eine komplexe SQL-Abfrage entziffern zu müssen.
Die Herkunft auf Spaltenebene wird automatisch für die folgenden Arten von BigQuery-Jobs erfasst:
Bei Managed Service for Apache Spark-Jobs hängt der Support vom Typ und der Version der Open Lineage-Abhängigkeit ab, die von Managed Service for Apache Spark verwendet wird. Die unterstützte Mindestversion ist 1.34. Die folgenden Mindestversionen von Cluster-Images für Managed Service for Apache Spark werden unterstützt:
- 3.0.3
- 2.3.22
- 2.2.75
- 2.1.107
Die folgenden Managed Service for Apache Spark-Laufzeitversionen werden mindestens unterstützt:
- 3.0.3
- 2.3.20
Lineage-Ansichten in der Google Cloud Console
In der Google Cloud -Konsole können Sie auf zwei Arten mit Herkunftsinformationen interagieren: Sie können das Herkunftsdiagramm in mehreren verfügbaren Regionen aufrufen oder das Herkunftsexplorer-Feld verwenden, um eine detailliertere Ansicht in einer bestimmten Region zu erhalten. Sie können auch zwischen der Diagramm- und der Listenansicht wechseln, um den Datenfluss auf verschiedenen Detailebenen zu analysieren.
Lineage-Ansichten sind nur für Knowledge Catalog-Einträge (früher Dataplex Universal Catalog), BigQuery-Assets und Vertex AI-Ressourcen (Modelle, Datasets, Feature Store-Ansichten und Featuregruppen) verfügbar.
Informationen zu den verschiedenen Ansichten, die in diesem Dokument beschrieben werden, finden Sie unter Data Lineage mit Google Cloud -Systemen verwenden.
Ansicht des Herkunftsdiagramms
In der Diagramm-Ansicht werden Datenfluss und Beziehungen zwischen Systemen und Regionen visualisiert. So können Sie die Datenarchitektur nachvollziehen, Quellen und Ziele ermitteln und Muster erkennen. Diese Herkunftsgraphen werden vom Data Lineage API-Dienst für einen bestimmten Knowledge Catalog-Eintrag generiert. Sie zeigen, wie Daten im Laufe der Zeit transformiert werden, und stellen Upstream-, Downstream- oder beide Flüsse von einem ausgewählten Stamm-Eintrag dar.
Die Data Lineage API empfängt automatisch Asset-Informationen aus unterstützten Systemen und über API-Aufrufe für benutzerdefinierte Quellen.
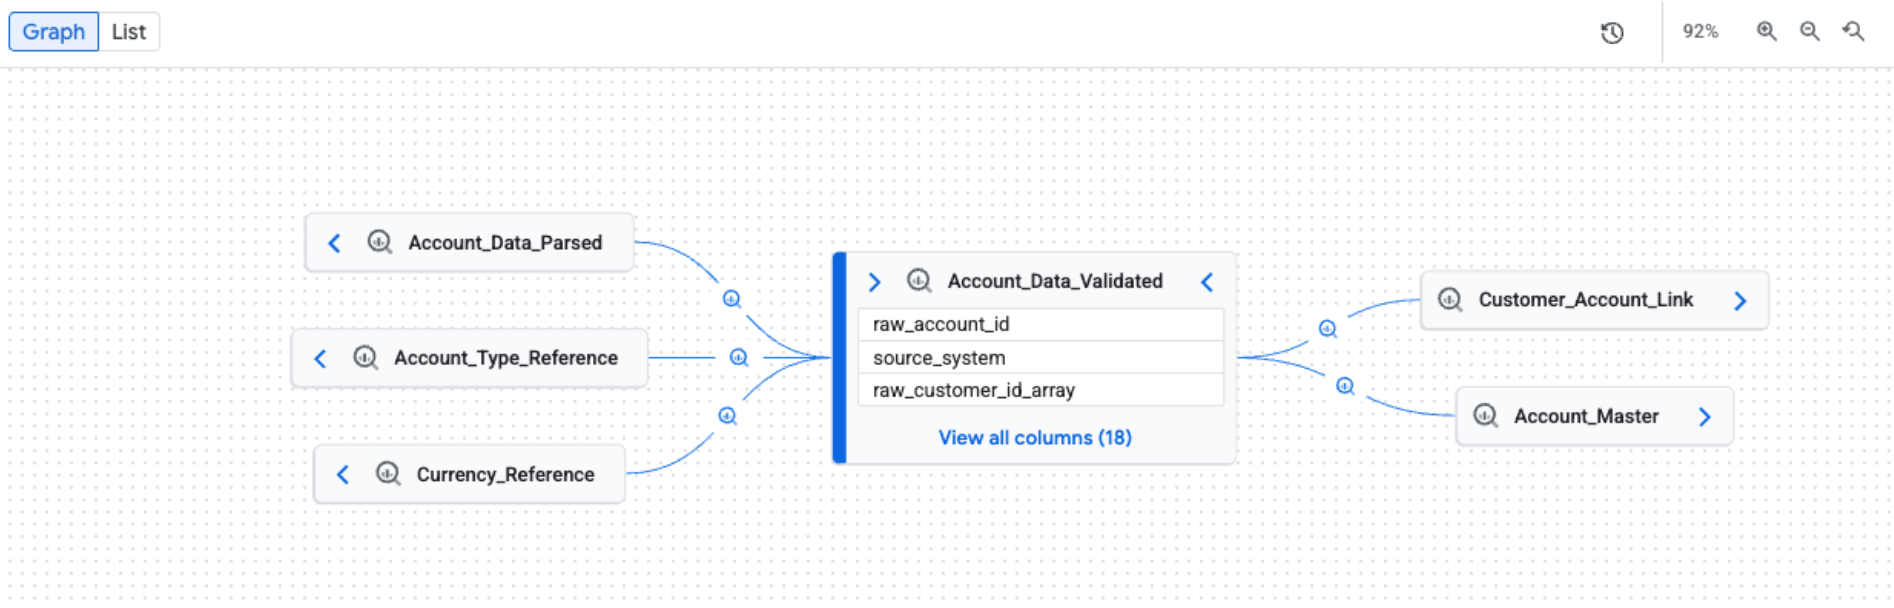
Die wichtigsten Elemente im Diagramm sind:
Knoten: Knoten stellen die Datenentitäten dar. In einer Ansicht auf Tabellenebene wird in einem Knoten der Tabellenname und die zugehörigen Spalten angezeigt. In einer Ansicht auf Spaltenebene stellt jeder Knoten eine bestimmte Tabelle und Spalte dar.
Kanten: Kanten sind die Linien, die Knoten verbinden und die Prozesse darstellen, die zwischen ihnen stattfinden. Die Darstellung einer Kante hängt von der Lineage-Ansicht ab:
- In der Ansicht auf Tabellenebene haben Kanten Symbole, die Datentransformationen angeben.
- In der Ansicht auf Spaltenebene haben Kanten Labels, die Datentransformationen angeben. Ein Kantenlabel könnte beispielsweise
Exact copylauten, um zu beschreiben, wie eine Quellspalte in eine Zielspalte kopiert wurde.
Prozesssymbole und ‑labels: An den Kanten werden Prozesssymbole und ‑labels angezeigt, um weitere Informationen zur Transformation zu liefern.
- Symbole: Symbole stellen den Transformationsprozess dar. Wenn Sie den Graphen manuell untersuchen, stellen Symbole auf Kanten das Quellsystem des Prozesses dar (z. B. BigQuery oder Vertex AI). Wenn mehrere Prozesse beteiligt sind, wird das Symbol „Mehrere Prozesse“ angezeigt. Wenn das Quellsystem des Prozesses unbekannt ist, wird ein Zahnradsymbol verwendet. Wenn Sie Filter anwenden, wird für alle Prozesse ein Zahnradsymbol verwendet.
- Labels: In der Lineage-Ansicht auf Spaltenebene wird der Typ der Abhängigkeit zwischen Spalten mit einem Label beschrieben:
Exact copyoderOther.
Lineage-Diagramm ansehen
Wenn Sie den Tab Lineage öffnen, wird standardmäßig die Diagrammansicht angezeigt. Die Standardansicht bietet einen allgemeinen Überblick über Systeme und Regionen hinweg. Der Graph kann manuell und inkrementell erweitert werden, wobei jeweils fünf Knoten geladen werden können. Prozesssymbole an den Kanten stellen das Quellsystem dar oder weisen auf mehrere Prozesse hin.
Datenreihenansichten filtern und hervorheben
Bei großen und komplexen Lineage-Diagrammen können Sie Filter oder Hervorhebungen anwenden, um visuelles Rauschen zu reduzieren und sich auf die Untersuchung der Lineage in einer bestimmten Region zu konzentrieren. Verwenden Sie den Bereich Lineage Explorer, um Ihre Kriterien festzulegen. Wenn Filter angewendet werden, wird oben in den Ansichten Diagramm und Liste eine Filterleiste angezeigt, in der Ihre aktiven Filter als Infofelder dargestellt werden.
Sie haben folgende Möglichkeiten, die Darstellung des Datenursprungs zu optimieren:
Hervorheben: Übereinstimmende Knoten werden durch Farben und Rahmen visuell hervorgehoben, während das gesamte Diagramm sichtbar bleibt. So lassen sich bestimmte Assets finden, ohne den Gesamtkontext des Herkunftsgraphen zu verlieren.
Filtern: Nicht übereinstimmende Knoten werden ausgeblendet und das Diagramm wird vereinfacht, sodass nur übereinstimmende Knoten und die Pfade zwischen ihnen angezeigt werden. Alle nicht übereinstimmenden Assets, die Teil eines Pfads zwischen übereinstimmenden Knoten sind, werden in minimierten Knoten gruppiert. Dieser Modus ist nützlich, um die Komplexität zu reduzieren und sich nur auf relevante Assets und ihre direkten Beziehungen zu konzentrieren.
Verwenden Sie die folgenden Kriterien, um die Herkunft zu filtern oder hervorzuheben:
- Projekt: Nach Google Cloud Projekt-ID filtern.
- System: Filtern Sie nach dem System, in dem sich das Daten-Asset befindet, z. B. BigQuery oder Cloud Storage.
- Entitätsname: Nach Assetname filtern. Sie können
*für Platzhaltersuchen verwenden (nur Präfix und Suffix, z. B.*tableodertest*). - Untertyp: nach Asset-Untertyp filtern (z. B.
dashboardodermodel). - Spaltenname: Filtern Sie die Herkunft nach Spaltenname, um Details auf Spaltenebene zu sehen.
- Richtung: Zeigen Sie die Herkunft oder die Weitergabe oder beides an.
- Zeitraum: Filtern Sie den Lineage-Verlauf nach einem bestimmten Start- oder Endzeitpunkt.
- Abhängigkeitstyp: Filtern Sie den Lineage auf Spaltenebene nach Abhängigkeitstyp.
Beispiele für verfügbare Optionen sind
AllundExact copy.
Um die Übersichtlichkeit weiter zu verbessern, können Sie Temporäre BigQuery-Tabellen ausblenden auswählen, um temporäre Assets auszublenden, die von BigQuery erstellt wurden, z. B. Tabellen in Datasets mit Namen, die mit _script beginnen.

In der fokussierten Ansicht auf dem Tab Diagramm wird das Diagramm automatisch auf bis zu drei Ebenen erweitert und die gesamte Lineage, die den Filterkriterien entspricht, wird geladen. Der Lineage Explorer ruft bis zu 10 Ebenen des Herkunftsgraphen ab, aber standardmäßig werden nur die ersten drei Ebenen maximiert. Sie können die Grafik maximieren, um die verbleibenden Ebenen zu sehen. Klicken Sie dazu auf die Pfeile.
Die fokussierte Ansicht unterstützt sowohl die Herkunft auf Tabellen- als auch auf Spaltenebene, einschließlich der Pfadvisualisierung von einem ausgewählten Knoten zurück zum Stamm. In dieser fokussierten Ansicht wird für alle Prozesse ein generisches Zahnradsymbol verwendet.

Verwenden Sie eine der folgenden Methoden, um die Herkunft auf Spaltenebene aufzurufen:
Klicken Sie in einer fokussierten Diagramm-Ansicht in einer Tabelle auf das Spaltensymbol, um zur Herkunft auf Spaltenebene zu wechseln.

Spaltensymbol Wenden Sie in der Standardansicht Diagramm oder in der fokussierten Ansicht Diagramm einen Spaltennamen im Bereich Lineage Explorer an.

Wenn Sie alle Filter entfernen und zur Standardansicht zurückkehren möchten, klicken Sie auf Zurücksetzen.
Informationen zum Wechseln zwischen den Modi „Hervorheben“ und „Filtern“ finden Sie unter Herkunftsvisualisierung optimieren.
Details zum Lineage-Knoten ansehen
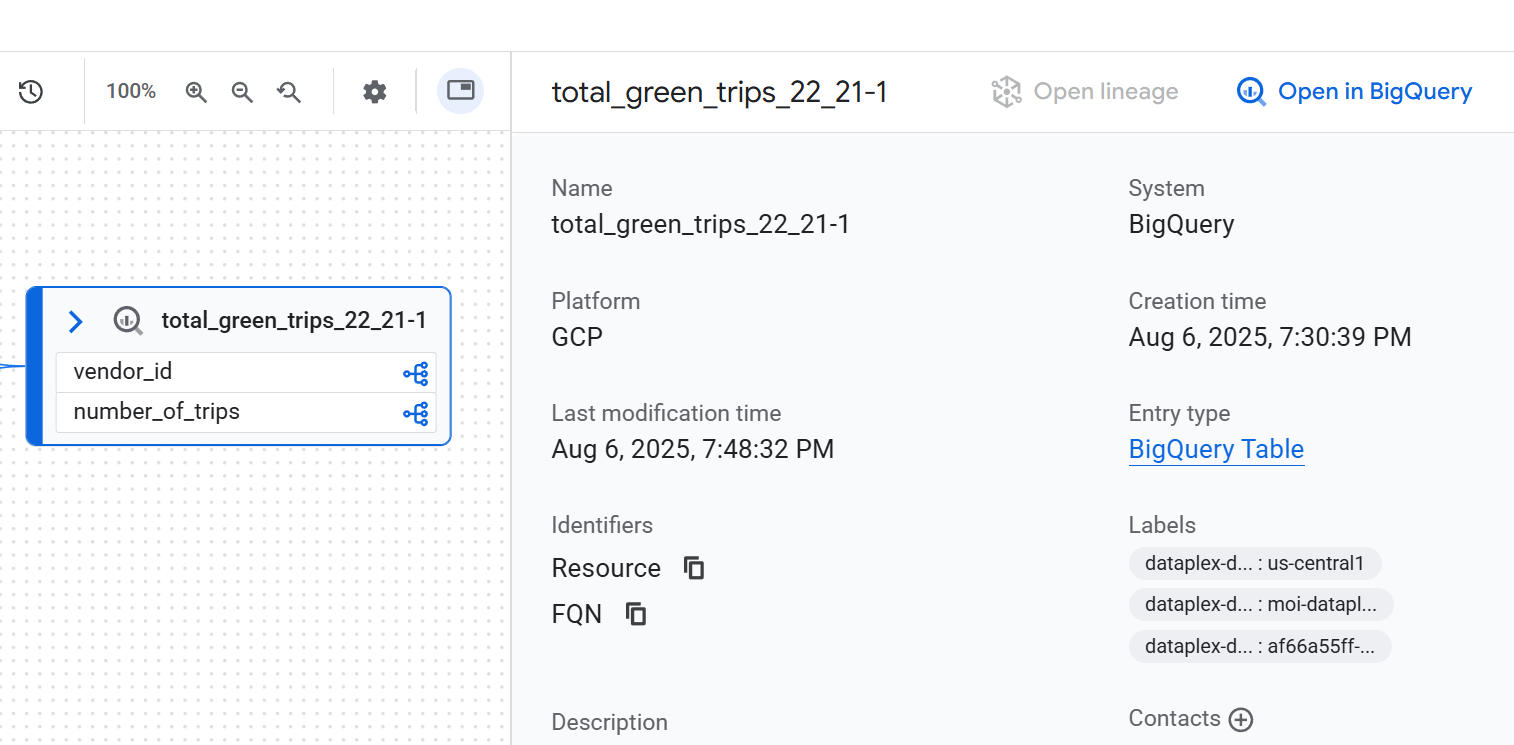
Klicken Sie auf einen Knoten, um die Details dazu aufzurufen. Eine Seitenleiste mit detaillierten Informationen zum ausgewählten Daten-Asset wird angezeigt. Wenn Sie beispielsweise in einer Ansicht des Datenursprungs auf Tabellenebene auf einen Knoten klicken, werden Informationen wie der voll qualifizierte Name, der Typ und andere relevante Attribute des Assets angezeigt.
Verlauf von Lineage-Ausführungen ansehen
Ein vollständiges Lineage-Diagramm ist das Ergebnis von Ausführungen vieler verschiedener Jobs. Für jeden Job wird ein bestimmter Link im Diagramm erstellt. Mehrere Ausführungen werden als neue Läufe protokolliert, ändern aber nicht das statische Erscheinungsbild des Diagramms.
Wenn Sie die Details der einzelnen Ausführungen sehen möchten, klicken Sie im Diagramm auf eine Kante mit einem Prozess. Klicken Sie im angezeigten Bereich Abfrage auf den Tab Ausführungen.

Datentransformationslogik prüfen
Wenn Sie die Geschäftslogik einer Transformation nachvollziehen möchten, ohne nach dem Code suchen zu müssen, können Sie die genaue SQL-Abfrage aufrufen, die ausgeführt wurde. Klicken Sie auf eine Kante mit einem Prozess im Diagramm, um den SQL-Code aufzurufen. Klicken Sie in der Seitenleiste, die angezeigt wird, auf den Tab Details.
Data-Lineage-Pfad visualisieren
Mit der Visualisierung des Herkunftspfads können Sie den Pfad von einem beliebigen ausgewählten Knoten im Diagramm zurück zum Stammeintrag nachvollziehen. Wenn Sie einen Knoten auswählen und auf Pfad visualisieren klicken, werden im Diagramm nur die Knoten und Prozesse hervorgehoben, die den direkten Lineage-Pfad zum Stammeintrag bilden.
Wenn Sie die Visualisierung des Lineage-Pfads sehen möchten, wenden Sie im Bereich Lineage Explorer einen Filter an, um eine fokussierte Graph-Ansicht zu erstellen. Wählen Sie dann in der fokussierten Diagramm-Ansicht einen Knoten aus. Klicken Sie im Detailbereich für den ausgewählten Knoten auf Pfad visualisieren.
Die Visualisierung des Herkunftspfads ist für die Herkunft auf Tabellen- und Spaltenebene verfügbar. Sie können auch die Visualisierung des Herkunftspfads in der Listenansicht verwenden.

Lineage-Listenansicht
Die Listenansicht bietet eine tabellarische, strukturierte Darstellung der Herkunft, die mit der Diagrammansicht synchronisiert wird. Sie können damit Daten-Assets sortieren, filtern und herunterladen. Diese Ansicht eignet sich ideal, um Quell-Ziel-Beziehungen zu analysieren, beteiligte Assets zu detaillieren und Lineage-Daten zu exportieren.
Die Listenansicht ist sowohl für die Herkunft auf Tabellen- als auch auf Spaltenebene verfügbar. Sie können zwischen den folgenden detaillierten und vereinfachten Listenansichten wechseln:
Vereinfachte Listenansicht: Diese Ansicht ist nützlich, um eine komprimierte, eindeutige Liste aller Assets zu erhalten, die in der Herkunft enthalten sind. Die Spalten wie System, Projekt, Entität, FQN (voll qualifizierter Name), Richtung und Tiefe helfen Ihnen, alle Datenassets in der Herkunft, ihren Speicherort, ihre ursprüngliche Quelle und ihre Entfernung vom zentralen Asset zu sehen, das analysiert wird. Es ist ideal für einen allgemeinen Überblick über alle am Datenfluss beteiligten Einheiten. Das ist die Standardansicht.
Detaillierte Listenansicht: Diese Ansicht ist für die Analyse einzelner Quell-Ziel-Beziehungen konzipiert. Wenn Sie separate Spalten für Quelle und Ziel angeben, können Sie jede spezifische Datenumwandlungsverknüpfung sehen. Diese Ansicht eignet sich ideal für Aufgaben, bei denen ein tiefes Verständnis dafür erforderlich ist, wie Daten zwischen bestimmten Asset-Paaren übertragen werden, z. B. zum Prüfen einzelner Datenflüsse, zum Nachvollziehen von Abhängigkeiten zwischen Tabellen oder zum Exportieren detaillierter Herkunftsdatensätze für jede Verbindung.
Listenansicht der Herkunft auf Tabellenebene
In dieser Ansicht werden Beziehungen zwischen Tabellen als Ganzes dargestellt. Wählen Sie mit den bereitgestellten Filtern die benötigten Spalten aus.

Maximieren Sie die folgenden Abschnitte, um die Spalten zu sehen, die in den Listenansichten auf Tabellenebene verfügbar sind.
In der vereinfachten Listenansicht auf Tabellenebene verfügbare Spalten
- System: Das System, in dem sich die Datenressource befindet. Beispiele: [BigQuery](/bigquery/docs).
- Projekt: Die Google Cloud Projekt-ID, die das Daten-Asset enthält.
- Entität: Der Name des Datenassets. Beispiele sind ein Tabellenname.
- FQN: Der voll qualifizierte Name (Fully Qualified Name, FQN) der ursprünglichen Quellentität oder ‑spalte.
- Richtung: Gibt an, ob das aufgeführte Asset im Lineage-Ablauf Upstream (Quelle) oder Downstream (Ziel) ist.
- Tiefe: Die Anzahl der Herkunftsschritte vom zentralen Asset, das analysiert wird.
In der detaillierten Listenansicht auf Tabellenebene verfügbare Spalten
- Quellsystem: Das System, in dem sich die Quelldatenressource befindet. Dazu gehört unter anderem BigQuery.
- Quellprojekt: Die Google Cloud Projekt-ID, die das Asset mit den Quelldaten enthält.
- Quelle: Der Name des Quelldaten-Assets. Beispiele sind ein Tabellenname.
- Voll qualifizierter Name der Quelle: Der voll qualifizierte Name der Quellentität.
- Zielsystem: Das System, in dem sich die Zieldatenressource befindet. Dazu gehört unter anderem BigQuery.
- Zielprojekt: Die Google Cloud Projekt-ID, die das Zieldaten-Asset enthält.
- Ziel: Der Name des Zieldaten-Assets. Beispiele sind ein Tabellenname.
- Voll qualifizierter Name des Ziels: Der voll qualifizierte Name des Zielobjekts.
- Richtung: Gibt an, ob das aufgeführte Asset im Lineage-Ablauf Upstream (Quelle) oder Downstream (Ziel) ist.
- Tiefe: Die Anzahl der Herkunftsschritte vom zentralen Asset, das analysiert wird.
Listenansicht der Herkunft auf Spaltenebene
In dieser Ansicht werden Beziehungen zwischen einzelnen Spalten in den Quell- und Zieltabellen dargestellt. Wählen Sie mit den bereitgestellten Filtern die benötigten Spalten aus.

Maximieren Sie die folgenden Abschnitte, um die Spalten zu sehen, die in den Listenansichten auf Spaltenebene verfügbar sind.
Verfügbare Spalten in der vereinfachten Listenansicht auf Spaltenebene
- System: Das System, in dem sich die Datenressource befindet. Beispiele: BigQuery.
- Projekt: Die Google Cloud Projekt-ID, die das Daten-Asset enthält.
- Entität: Der Name des Datenassets. Beispiele sind ein Tabellenname.
- Spalte: Die spezifische Spalte, die im Bereich Lineage Explorer innerhalb der Entität ausgewählt wurde.
- FQN: Der voll qualifizierte Name (Fully Qualified Name, FQN) der ursprünglichen Quellentität oder ‑spalte.
- Richtung: Gibt an, ob das aufgeführte Asset im Lineage-Ablauf Upstream (Quelle) oder Downstream (Ziel) ist.
- Tiefe: Die Anzahl der Herkunftsschritte vom zentralen Asset, das analysiert wird.
Spalten in der detaillierten Listenansicht auf Spaltenebene
- Quellsystem: Das System, in dem sich die Quelldatenressource befindet.
- Quellprojekt: Die Google Cloud Projekt-ID, die das Quelldaten-Asset enthält.
- Voll qualifizierter Name der Quelle: Der voll qualifizierte Name der Quellspalte.
- Zielsystem: Das System, in dem sich die Zieldatenressource befindet.
- Zielprojekt: Die Google Cloud Projekt-ID, die das Zieldaten-Asset enthält.
- Voll qualifizierter Name des Ziels: Der voll qualifizierte Name der Zielspalte.
- Richtung: Gibt an, ob der Datenfluss Upstream oder Downstream ist.
- Abhängigkeitstypen: Beschreibt die Art der Beziehung zwischen den Spalten.
- Tiefe: Die Anzahl der Herkunftsschritte vom zentralen Asset, das analysiert wird.
Nächste Schritte
Informationen zum Nachverfolgen der Datenherkunft für eine BigQuery-Tabellenkopie und Abfragejobs
Informationen zur Verwendung von Data Lineage mit Google Cloud -Systemen